파드 타임아웃 원인 분석
에러 메일로 파드 생성 API에서 타임아웃이 종종 발생한다는 알림이 오길래 대수롭지 않게 넘기려다가, 빈도가 계속 신경 쓰여서 원인을 파봤다.
증상
프록시 서비스를 거쳐 내부 파드 관리 API로 요청을 보내는 구조인데, 이 구간에서 timeout이 간헐적으로 터졌다. 처음엔 그냥 네트워크가 가끔 불안정한 거겠지, 하고 넘어갈 뻔했다. 재시도하면 되기도 하고 안되기도 하니 더 그렇게 생각했던 것 같다.
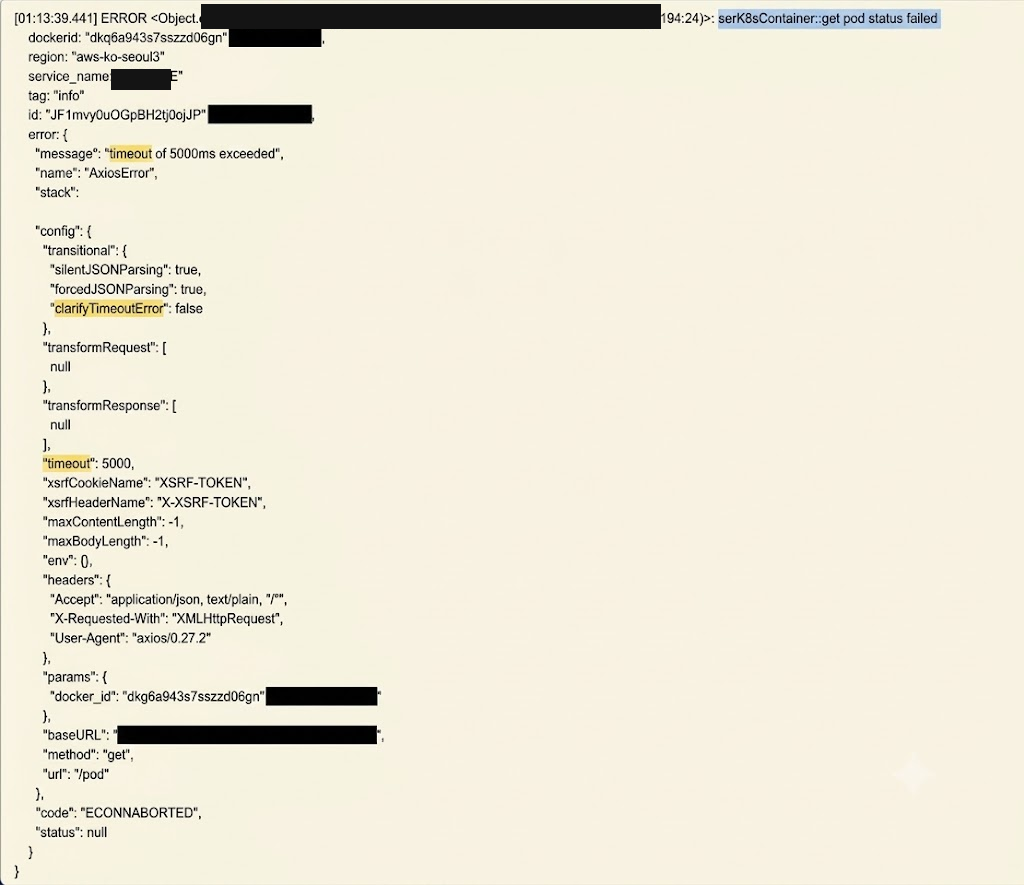
근데 실제로 같은 파드에서 curl로 직접 요청을 반복해보니 재현이 됐다. 도메인 하나에 IP가 두 개 물려 있는데, 그 중 특정 IP로 요청이 가면 항상 timeout이 나고 나머지 IP로 가면 항상 성공했다. 랜덤이 아니라 IP 단위로 로그를 찍어보니 패턴이 명확했다.
왜 특정 IP만 실패하는가
로드밸런서가 멀티 AZ로 구성되어 있고, DNS 조회 결과로 두 AZ의 엔드포인트 IP가 둘 다 반환되는 구조였다. 그런데 실제로 요청을 처리해야 할 파드는 한 AZ에만 떠 있었다. 그러니까 클라이언트 → DNS 응답(둘 중 하나의 IP) → 로드밸런서(멀티 AZ) → 파드(싱글 AZ)로 이어지는 흐름에서, DNS가 파드가 없는 쪽 AZ의 IP를 돌려주면 TCP 연결까지는 되는데 실제로 트래픽을 넘길 대상이 없어서 그대로 타임아웃이 나는 것이었다.
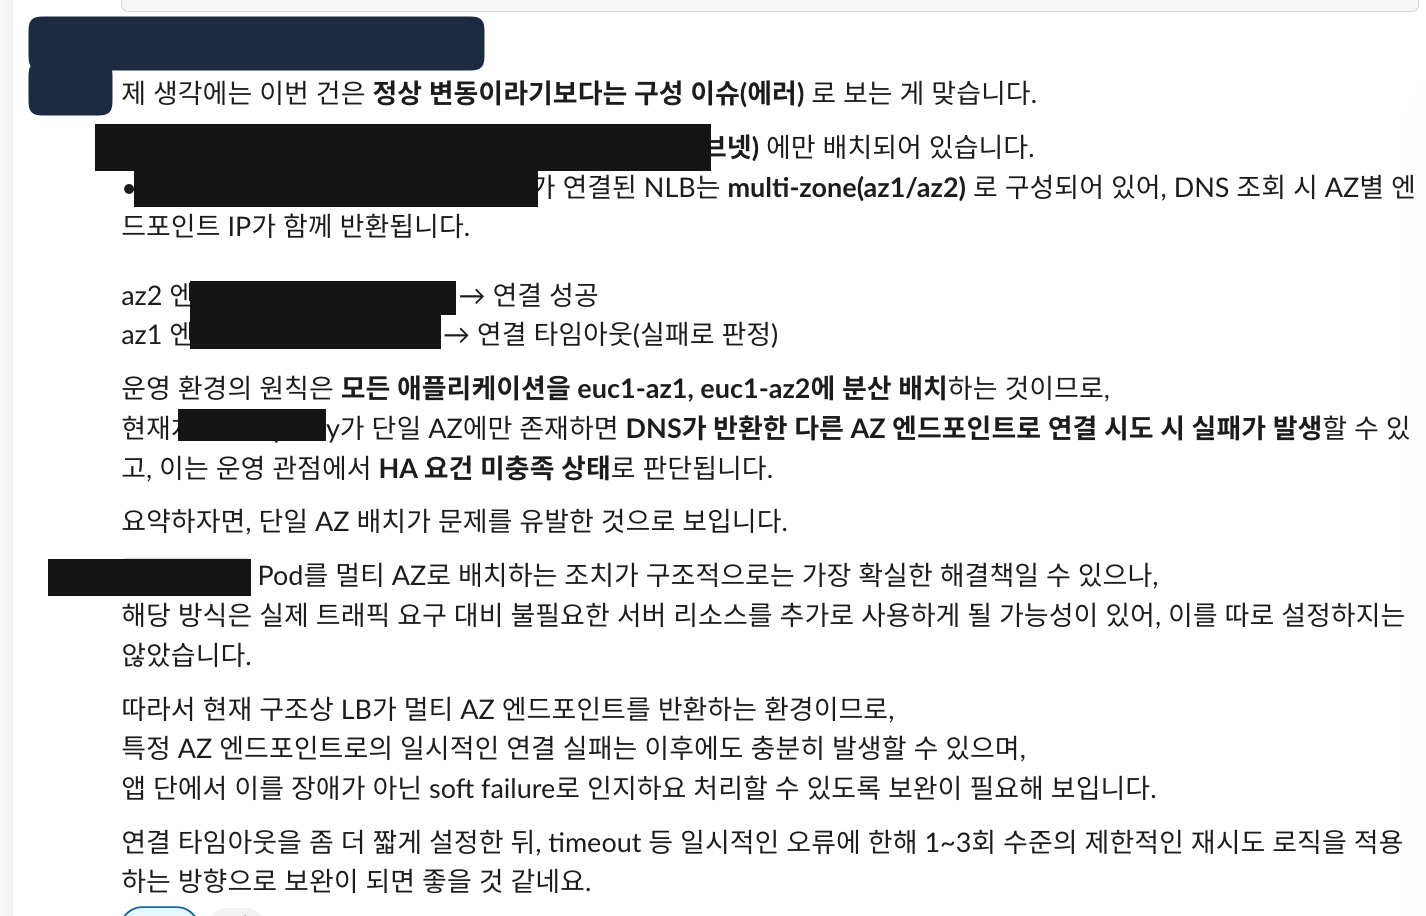
즉 네트워크가 불안정한 게 아니라 로드밸런서와 애플리케이션이 서로 다른 가정을 하고 있었던 거다. 로드밸런서는 멀티 AZ 전제로 양쪽 AZ의 엔드포인트를 다 돌려주는데, 파드는 비용 때문인지 한쪽 AZ에만 배치돼 있었으니 HA 관점에서 애초에 안 맞는 구성이었던 셈이다. 클라이언트는 DNS 응답 중 아무 IP나 골라서 쓰고, 재시도해도 같은 IP를 계속 잡을 수 있으니 일부 트래픽은 계속 실패할 수밖에 없는 구조였다.
파드를 멀티 AZ로 다 띄우면 구조적으로는 깔끔하게 해결되긴 하는데, 그만큼 리소스가 더 들어간다. 지금 트래픽 규모에서 그 비용을 감수할 정도는 아니라고 판단해서 앱단에서 완화하는 쪽으로 방향을 잡았다.
재시도 로직으로 완화
어차피 도메인에 붙어있는 IP 중 하나는 정상 동작하니, 한 번 요청하고 길게 기다리는 것보다 짧은 주기로 재시도를 여러 번 넣는 게 나아 보였다.
| 구분 | 기존 | 변경 |
|---|---|---|
| 파드 생성 | timeout 5초 | timeout 3초, retry 5회 |
| 파드 삭제 | timeout 60초 | timeout 30초, retry 3회 |
파드 삭제 쪽은 30초 × 3회면 최대 90초까지 걸릴 수 있는데, 앞단 nginx 타임아웃이 60초로 걸려 있어서 이 값이 맞는 건지는 사실 아직도 좀 헷갈린다. 일단은 실패한 요청이 같은 실패 IP를 계속 잡는 것보다는 짧게 여러 번 시도해서 다른 IP로 넘어갈 확률을 높이는 쪽이 실질적으로 도움이 됐다.