LiteLLM 동시성 제한
litellm 프록시로 나가는 요청이 너무 많이 몰려서 동시 호출 수를 제한하는 작업을 하다가, 분명 제한을 걸었는데 실제로는 하나도 안 걸리고 있던 걸 발견해서 이 글을 정리하게 되었다.
배경
에이전트가 LLM을 호출하는 경로는 ChatOpenAI 인스턴스를 만들고 그걸 그대로 쓰는 구조다. 그래서 처음 접근은 단순했다. 인스턴스의 invoke/stream 메서드를 몽키패치해서 p-limit 같은 세마포어로 감싸면 되겠지 → 동시에 뜰 수 있는 요청 수를 제한값 이하로 묶어두고, 넘치는 건 큐에서 기다리게 하면 된다고 생각했다.
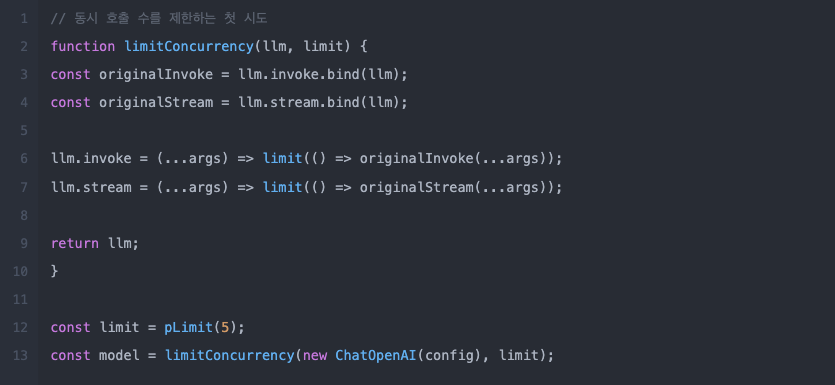
테스트도 다 통과했다. 유닛테스트에서 가짜 모델 객체를 만들어서 invoke를 여러 번 동시에 부르고, limit.activeCount가 설정값을 안 넘는지 확인하는 식이었는데 전부 초록불이었다.
부하테스트에서 이상한 게 보였다
문제는 실제 부하테스트를 돌렸을 때였다. 동시성 제한을 5로 걸어놨는데 프록시 쪽에서 관측되는 동시 요청 수가 5를 훌쩍 넘어가고 있었다. 처음엔 측정 지점이 잘못됐나 싶어서 로그를 더 찍어봤는데, limit.activeCount는 그대로 0에서 안 움직이는 채로 요청은 계속 나가고 있었다. 제한 로직 자체가 전혀 타지 않고 있다는 뜻이었다.
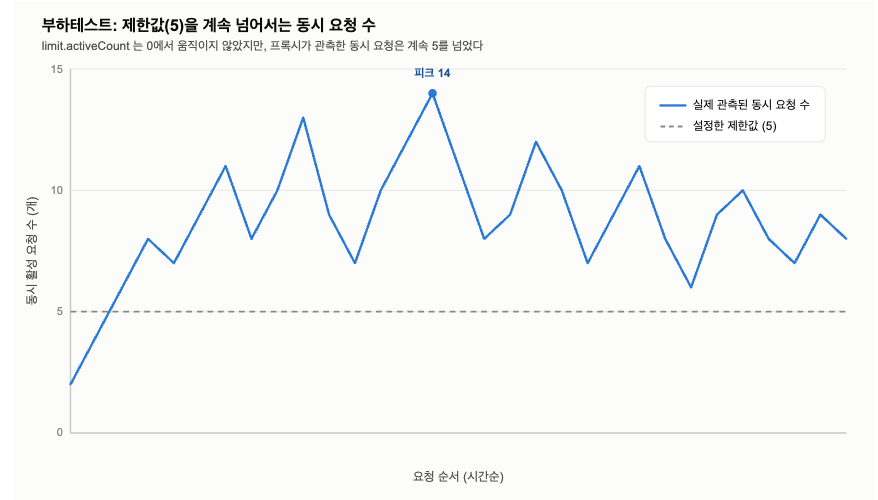
유닛테스트는 다 통과했는데 왜 프로덕션에서는 안 먹힐까 → 여기서 유닛테스트가 손으로 만든 가짜 모델만 테스트하고, 실제 ChatOpenAI를 에이전트 경로 그대로(즉 bindTools()를 거쳐서) 통과시켜본 적이 한 번도 없었다는 걸 깨달았다. 코드를 읽고 “이렇게 동작할 것이다”라고 가정만 했지, 실제 실행 경로를 따라가보지는 않았던 것.
bindTools()가 새 인스턴스를 만들고 있었다
그래서 실제 에이전트가 쓰는 경로를 그대로 실행해보기로 했다. llm.bindTools(...)를 호출한 뒤에 반환된 객체가 패치해둔 인스턴스와 같은 건지 확인하는 코드를 넣어서 돌려봤다.
결과는 완전히 새로운 ChatOpenAI 인스턴스였다. RunnableBinding처럼 원본 인스턴스를 감싸는 형태일 거라고 막연히 생각했는데, 실제로는 withConfig() 내부에서 new ChatOpenAI(this.fields)로 통째로 복제하고 있었다. 패치해둔 invoke/stream은 그 인스턴스에만 붙어있던 own-property라서, 복제되는 순간 그냥 사라지는 것이었다. 에이전트가 매 호출마다 bindTools()를 거치니까, 결국 몽키패치는 한 번도 실제 호출 경로에 올라타지 못하고 있었던 셈이다.
미들웨어 쪽에서 clone이 생길 때마다 다시 패치를 걸어주는 방어 코드를 추가해봐도 마찬가지였다. bindTools()가 그 뒤에 한 번 더 clone을 만들어버려서 또 무효화됐다. 인스턴스 메서드를 패치하는 방식 자체가, clone이 반복되는 구조 앞에서는 근본적으로 이길 수 없는 싸움이었다.
fetch 레벨로 내려서 재설계
그래서 패치 대상을 인스턴스 메서드가 아니라 생성자 옵션 쪽으로 옮겼다. ChatOpenAI 생성자에 configuration.fetch로 제한 로직이 들어간 fetch 함수를 주입하는 방식이다. bindTools()나 withConfig()가 새 인스턴스를 만들어도, 그 생성자 인자(lc_kwargs)는 그대로 상속되기 때문에 configuration도 함께 넘어간다 → 즉 clone이 몇 번을 거치든 동일한 제한된 fetch를 계속 쓰게 되는 것이다.
실제로 ChatOpenAI를 만들고 bindTools()까지 통과시킨 다음에 동시성 제한이 걸리는지 확인하는 테스트를 새로 추가해서 검증했다. 이번에는 limit.activeCount가 실제로 움직였다.
부수적으로 스트리밍 응답에서 헤더는 왔는데 청크가 안 오고 계속 멈춰있는 경우도 처리해야 했다. timeout이 있긴 했지만 헤더 도착 시점에 타이머가 해제돼서, 바디 스트리밍이 멈추는 건 못 잡고 있었다. 청크가 안 올 때마다 리셋되는 idle watchdog을 별도로 붙였고, 이 타이머 덕분에 스트림을 끝까지 순회하지 않고 버려지는 경우의 슬롯 누수 문제도 같이 해결됐다.
서킷 브레이커 도입은 이번 스코프에서는 설계만 남기고 구현은 다음으로 미뤘다. 코드를 읽고 “될 것 같다”고 넘어가는 것과 실제로 그 경로를 실행해서 확인하는 것 사이에 이렇게 큰 차이가 날 수 있다는 걸 이번에 제대로 느꼈다.