Codegraph
프로젝트가 점점 커지다 보니 코드 하나 찾는데도 grep을 몇 번씩 돌려야 하는 상황이 반복되어서, Claude Code에서 codegraph라는 MCP를 붙여서 써보게 되었다. 실제로 쓰던 프로젝트 기준으로 파일 162개, 노드 1629개, 엣지 3277개 정도 되는 규모인데 이 정도만 되어도 grep 기반 탐색이랑 codegraph 기반 탐색이랑 체감 차이가 꽤 크다.
뭐가 문제였나
grep으로 함수 하나 찾으려고 하면 이름이 겹치는 변수나 주석 안에 있는 텍스트까지 다 걸려서 결과를 눈으로 한번 더 걸러야 한다. 함수 하나의 의존성을 보려면 파일 열고 import 따라가고 또 파일 열고… 이걸 반복해야 하는데 함수가 몇 단계 걸쳐서 호출되는 구조면 수분씩 걸리기도 한다. 이 함수를 누가 호출하는지 확인할 때도 마찬가지로 grep 걸고 나온 결과를 하나하나 확인해야 했다. 코드베이스가 작을 때는 그냥 grep+Read 조합으로 버틸만 한데 커지니까 이게 좀 힘들어졌다.
속도 비교
| 작업 | codegraph 없이 | codegraph 사용 |
|---|---|---|
| 특정 함수 위치 찾기 | grep 여러 번, 수초~수십초 | codegraph_search 1회, 즉시 |
| 함수 의존성 파악 | 파일 열기 → import 추적 반복, 수분 | codegraph_explore 1회로 call path까지 확인 |
| 호출자 확인 | grep + 수동 확인 | codegraph_callers 즉시 |
| 파일 구조 파악 | find/ls 반복 | codegraph_files 1회, 언어·심볼 수 포함 |
| 변경 영향 범위 | 수동 추적 | codegraph_impact, blast radius 자동 계산 |
codegraph는 SQLite 기반 인덱스를 쓰는데 응답이 sub-millisecond 단위라고 한다. grep/find 대비 대부분의 탐색에서 수배에서 수십배까지 빨라지는 것 같다.
정확도랑 컨텍스트 소모
grep은 결국 문자열 매칭이라 변수명이 우연히 겹치거나 주석 안에 같은 텍스트가 있으면 노이즈가 낀다. codegraph는 심볼 단위로 인덱싱을 해놔서 정확한 정의 위치만 돌려준다.
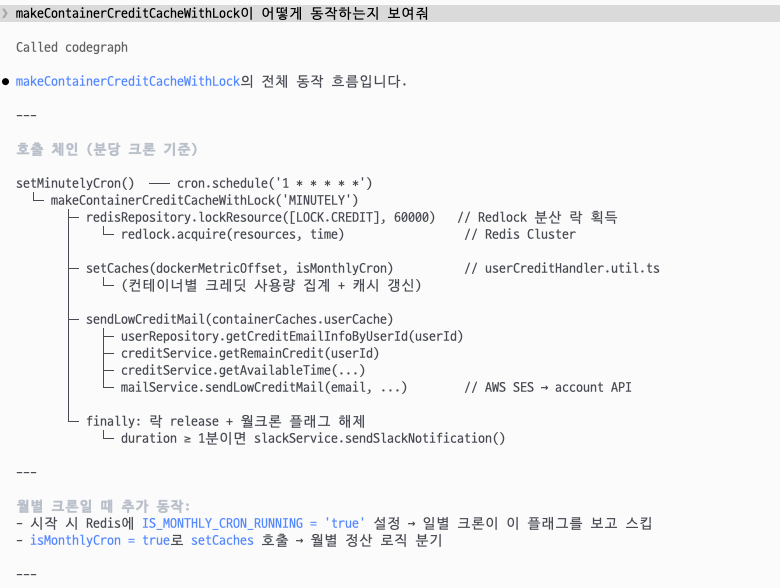
호출 관계 파악할 때도 차이가 크다. grep으로는 A→B→C 흐름을 손으로 하나하나 따라가야 하는데, codegraph_explore는 call path를 자동으로 그려준다. 심지어 콜백이나 React re-render처럼 grep으로는 추적이 아예 불가능한 동적 디스패치 경로도 잡아준다.
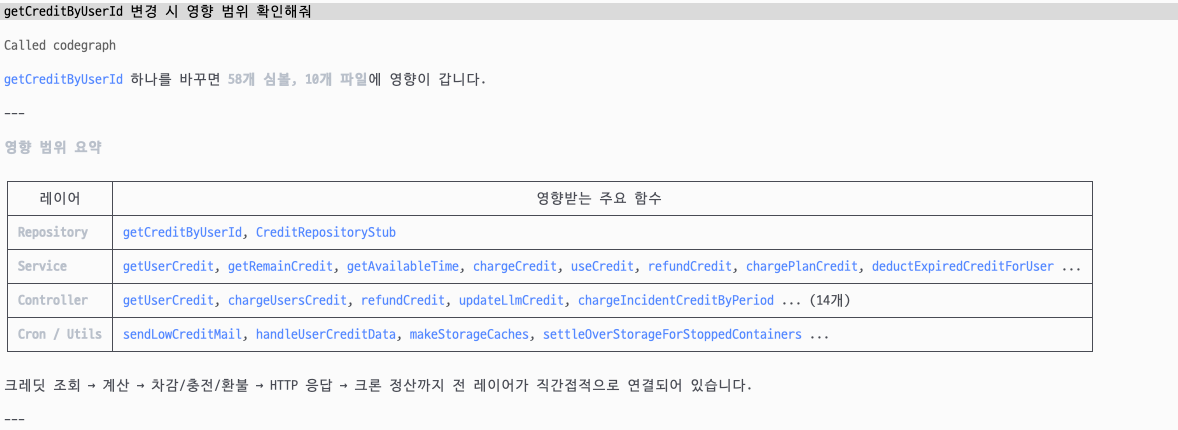
영향 범위(blast radius) 확인할 때도 codegraph_impact나 codegraph_explore의 blast radius 섹션에서 callers 목록이랑 커버리지 경고가 바로 뜨는데, 이걸 grep으로 하려면 코드베이스 전체를 수동으로 뒤져야 해서 시간이 꽤 걸린다.
작업하다 보니 느낀건데 context 소모 측면에서도 차이가 있다. grep 결과나 Read 한 파일들이 계속 쌓이면 장시간 작업할 때 컨텍스트가 압축되는 상황이 오는데, codegraph는 한두 번 탐색으로 압축된 정보를 받아오니까 이 부분에서 좀 절약이 되는 것 같다.
주의할 점
codegraph의 “covering tests” 감지는 정적 call edge 기반으로 동작한다. 근데 jest.mock()처럼 런타임에 모듈을 교체하는 패턴은 이 call edge로 안 잡힌다.
// 이런 패턴은 codegraph가 call edge로 인식하지 못한다
jest.mock('@services/creditCalculation.service', () => ({
  getCreditAndUsageByResource: jest.fn(),
}));
그래서 실제로는 테스트가 있는데도 “no covering tests found” 경고가 뜨는 경우가 있었다. 이건 codegraph 정적 분석의 한계지 실제로 테스트가 없다는 뜻은 아니라서, 이 경고가 뜨면 바로 믿지 말고 Jest를 직접 돌려서 확인해봐야 한다.
언제 쓰면 좋은가
함수/심볼 위치를 빠르게 찾을 땐 codegraph_search, 이 함수가 어떻게 동작하는지 파악할 땐 codegraph_explore, 수정 전 영향 범위 확인할 땐 codegraph_impact나 codegraph_callers, 프로젝트 전체 구조 파악할 땐 codegraph_files를 쓰면 되는 것 같다. 반대로 로그 메시지나 에러 문자열처럼 단순 문자열 검색은 그냥 grep이 낫고, 특정 파일의 특정 라인 확인은 Read 도구가 더 빠르다.
코드베이스 규모가 커질수록 codegraph 쓰는 효과가 두드러지는 것 같다. 다만 위에 적은 것처럼 테스트 커버리지 감지에는 맹점이 있으니 이 부분은 감안하고 쓰는게 좋을 듯 하다.