컨테이너가 stopping에서 안 넘어가는 버그
관리자 도구에서 컨테이너를 정지시켰는데 상태가 stopping에서 stopped로 안 넘어가고 계속 멈춰있다는 제보를 받았다. 재실행도 안 되고 삭제도 안 되길래 원인을 찾아보게 되었다.
증상
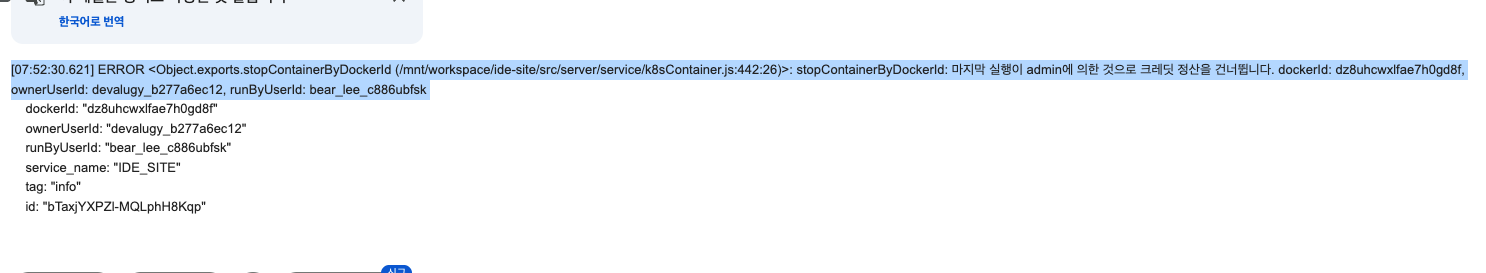
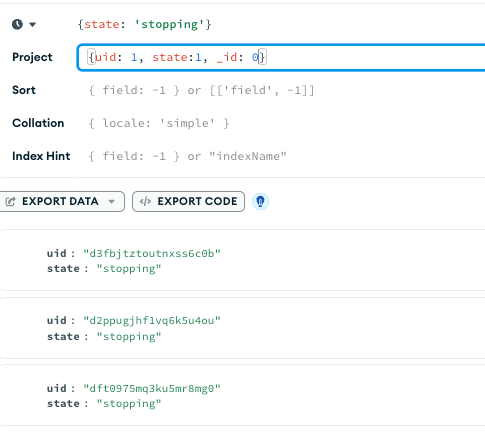
admin 화면에서 실행 중인 컨테이너를 정지시키면 정상적으로는 running → stopping → stopped 순으로 상태가 바뀌어야 하는데, 몇몇 컨테이너가 stopping에 영구적으로 고정되어 있었다. 로그를 보면 정지 요청 자체는 들어왔고 실제 컨테이너 프로세스도 내려간 것 같은데, DB상 상태값만 stopping으로 남아있는 상황.
코드 추적
정지 처리하는 함수를 따라가봤다. 대략 이런 흐름이었다.
let isStopped = true;
if (needSideEffect) {
    isStopped = await service.updateCreditAndResource({
        dockerId, traffic, reason,
    });
}

if (!needSideEffect || isStopped) {
    await service.updateContainerState(dockerId, STATE.STOPPED);
}
updateCreditAndResource는 컨테이너 사용량에 따라 크레딧을 정산하는 부가 로직이다. 근데 이 함수가 내부에서 axios로 다른 서비스(크레딧 관리 서비스)를 호출하고, 거기서 마지막 실행 로그의 reason이 admin이면 “정산 대상 아님”이라며 비정상 응답을 돌려주고 있었다. 그러면 axios catch 블록이 타면서 isStopped = false가 되고, 위 조건문 !needSideEffect || isStopped가 false가 되어 STOPPED로 전환하는 코드 자체가 실행이 안 되는 구조였다.
즉 관리자가 직접 실행시킨 컨테이너를 정지할 때만 재현되는 버그였는데, admin이 실행한 건 크레딧 정산 대상이 아니라서 크레딧 서비스가 에러를 주고 → 그 에러 때문에 컨테이너 정지라는 핵심 로직까지 같이 실패 취급되는 흐름이었다.
진짜 원인
정지 자체는 이미 잘 된 상태였다. 문제는 “정지가 됐는가”와 “부가 작업(크레딧 정산)이 성공했는가”가 하나의 성공/실패로 묶여있었다는 것. 크레딧 정산은 컨테이너를 실제로 멈추는 것과는 별개의 관심사인데, 코드상으로는 isStopped라는 변수 하나가 둘 다를 대표하고 있었다. 크레딧 서비스 쪽에서 admin 실행 건을 걸러내려고 만든 로직이 여기서는 전혀 예상 못한 부작용을 낸 셈이다.
고치는 방법은 생각보다 단순했다. 크레딧 호출 전에 마지막 실행 로그를 먼저 조회해서, reason이 admin이면 애초에 크레딧 호출 자체를 건너뛰고 상태 전이는 정상적으로 진행되게 했다. 대신 이 케이스를 그냥 조용히 넘기면 나중에 추적이 안 되니까, 컨테이너 소유자가 일반 유저인 경우에는 에러 레벨 로그를 남겨서 메일로 알림이 가도록 했다 (owner가 관리자면 admin이 admin 걸 정지한 거니까 알림 없이 넘어가도 됨).
let isStopped = true;
if (needSideEffect) {
    const lastRunLog = await modRunLog.getLastRunLogByUid(dockerId);
    const isAdminRun = lastRunLog?.reason === REASON_TYPE.ADMIN;

    if (isAdminRun) {
        const owner = await modResource.getOwnerByDockerId(dockerId);
        const ownerLevel = owner ? await modUser.getLevelByUserId(owner.userId) : undefined;

        if (!(ownerLevel >= ADMIN_LEVEL)) {
            logger.error(
                { dockerId, owner, runBy: lastRunLog.userId },
                `admin 실행 건이라 크레딧 정산을 건너뜁니다`,
            );
        }
        // isStopped = true 유지, 상태 전이는 그대로 진행
    } else {
        isStopped = await service.updateCreditAndResource({ dockerId, traffic, reason });
    }
}

if (!needSideEffect || isStopped) {
    await service.updateContainerState(dockerId, STATE.STOPPED);
}
느낀 점
핵심 로직(컨테이너를 실제로 멈추는 것)과 부가 로직(크레딧 정산, 알림 같은 것)의 실패를 하나의 플래그로 묶어버리면, 부가 로직 쪽에서 아무리 사소한 예외 케이스를 처리해도 그게 핵심 상태 전이 전체를 막아버릴 수 있다는 걸 알게 됐다. 특히 상태 머신을 다루는 코드에서는 “이 상태 전이가 실패했을 때 정말 롤백해야 하는가, 아니면 그냥 로그만 남기고 넘어가도 되는가”를 미리 나눠서 생각해야 할 것 같다. 여기서는 크레딧 정산 실패가 정지 자체를 막을 이유가 전혀 없었는데, 코드 구조상 우연히 같이 묶여버린 케이스였다.
부가 작업은 실패해도 핵심 상태 전이에 영향을 주지 않게 분리하고, 대신 그 실패는 로그나 알림으로 어딘가엔 남겨야 나중에 추적이 가능하다. 이번 경우처럼 실패를 조용히 삼키면 안 되지만, 그렇다고 핵심 로직까지 막아버리는 것도 답은 아니었다.